概率论与数理统计 · 第二章
随机变量及其分布
分布函数、离散与连续分布、变量函数的分布
随机变量与分布函数
随机变量是定义在样本空间上的实值函数。分布函数
F(x)=P{X≤x}
单调不减、右连续,并满足 F(−∞)=0、F(+∞)=1。区间概率为 P{a<X≤b}=F(b)−F(a)。
离散型随机变量
离散型随机变量用分布律 P{X=xk}=pk 描述,要求 pk≥0 且 ∑kpk=1。分布函数是右连续阶梯函数。
常用离散分布
| 分布 | 分布律 | 期望 | 方差 |
|---|
| 0-1 分布 | P(X=1)=p | p | p(1−p) |
| 二项分布 B(n,p) | Cnkpk(1−p)n−k | np | np(1−p) |
| 几何分布 | (1−p)k−1p,k≥1 | 1/p | (1−p)/p2 |
| 泊松分布 P(λ) | e−λλk/k! | λ | λ |
几何分布具有无记忆性。二项分布在 n 大、p 小且 np≈λ 时可用泊松分布近似。
连续型随机变量
若存在非负函数 f 使 F(x)=∫−∞xf(t)dt,则 f 为概率密度,并满足 ∫−∞+∞f=1。连续型随机变量在单点取值的概率为 0。
易错 概率密度值可以大于 1;只有区间上的积分才是概率。
常用连续分布
| 分布 | 概率密度 | 期望 | 方差 |
|---|
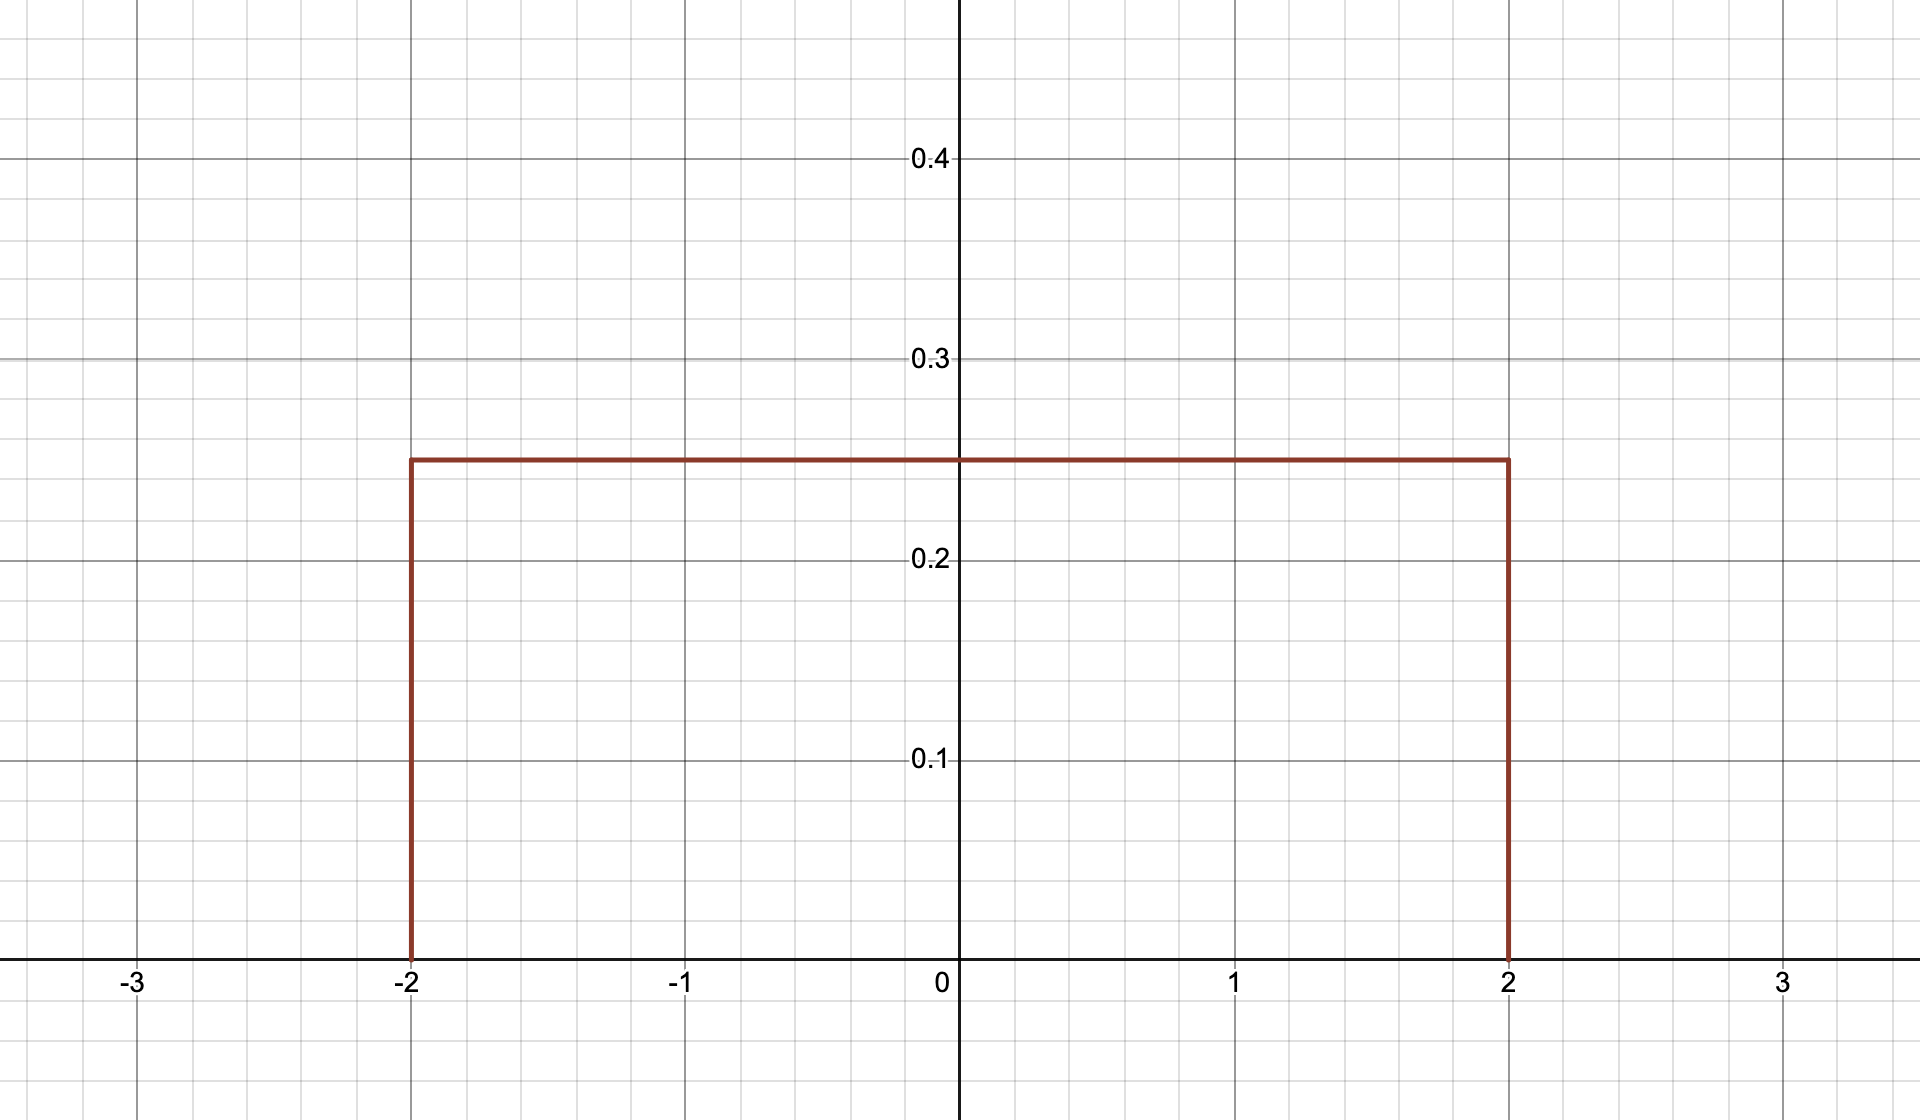
| 均匀分布 U(a,b) | 1/(b−a) | (a+b)/2 | (b−a)2/12 |
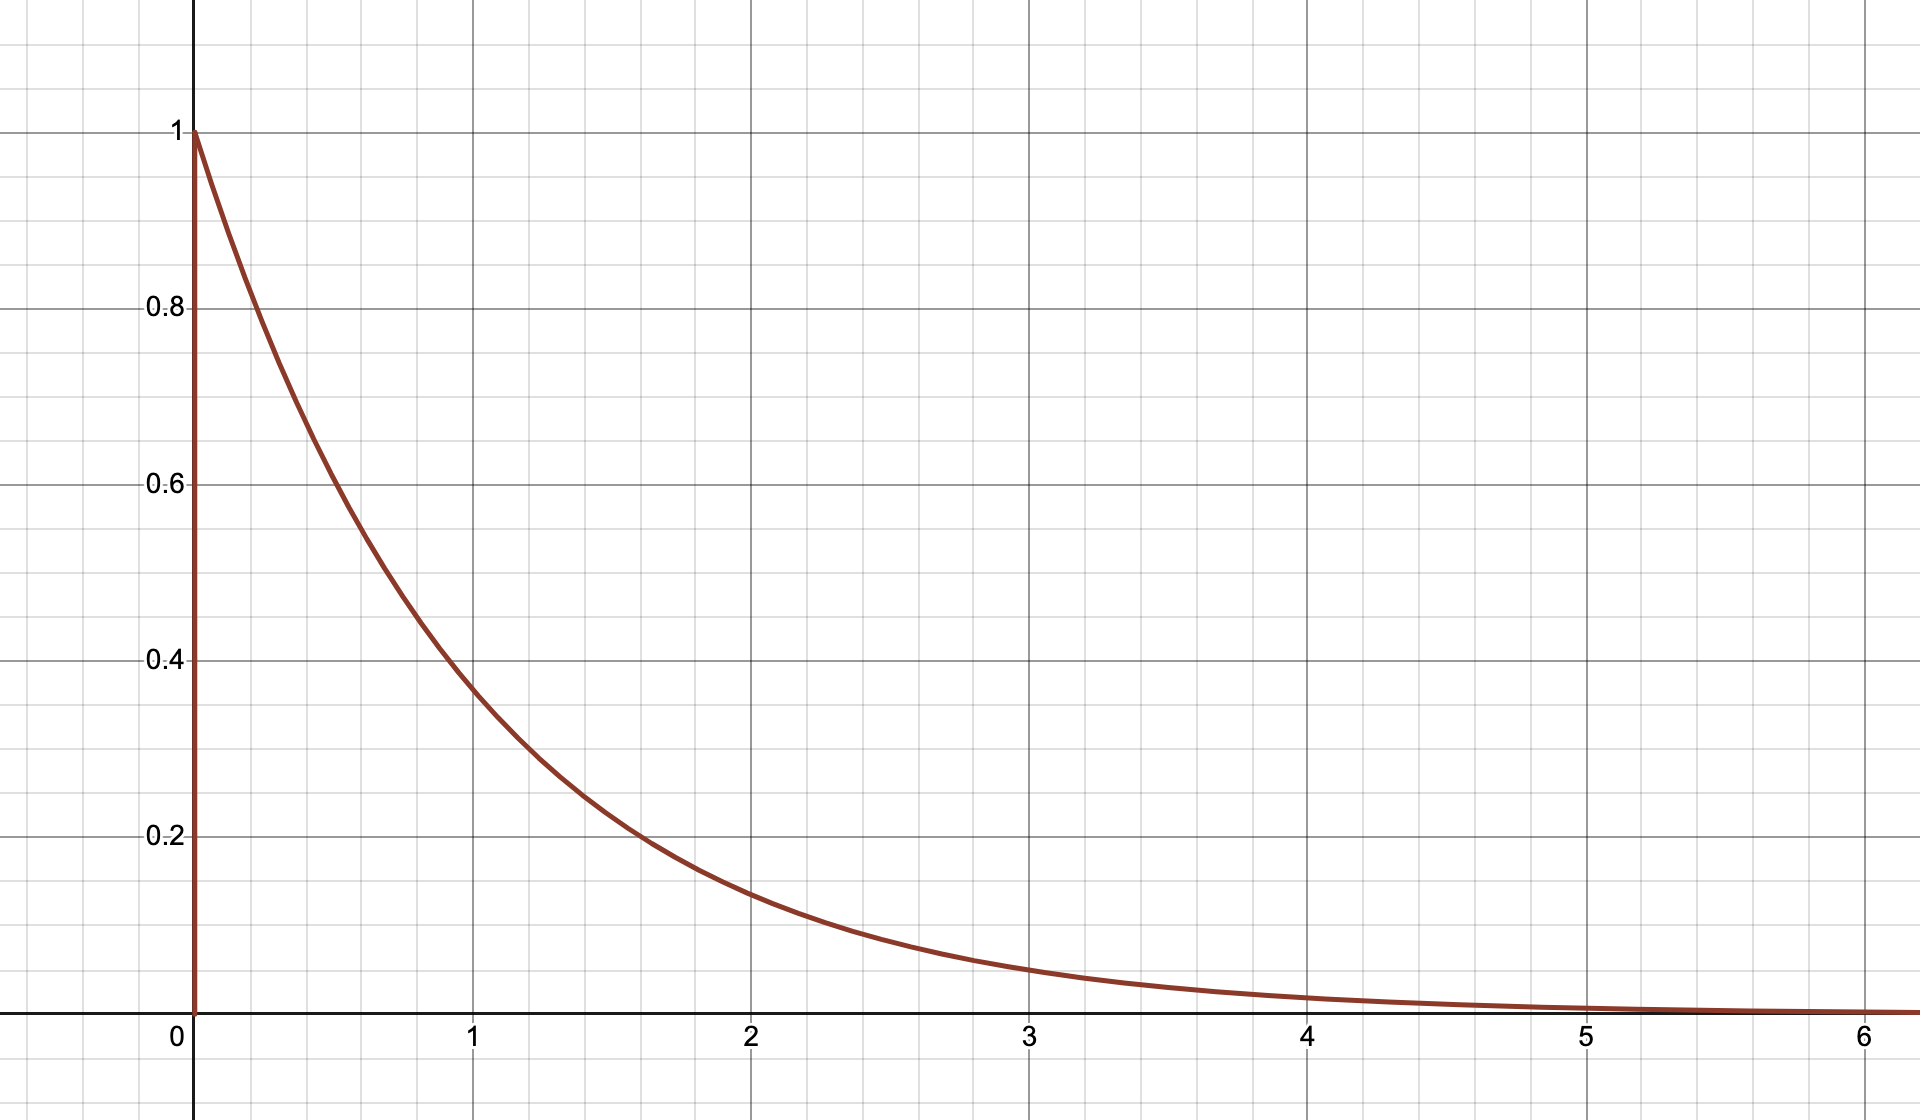
| 指数分布 E(λ) | λe−λx, x>0 | 1/λ | 1/λ2 |
| 伽马分布(Γ 分布)Γ(α,λ) | Γ(α)λαxα−1e−λx | α/λ | α/λ2 |
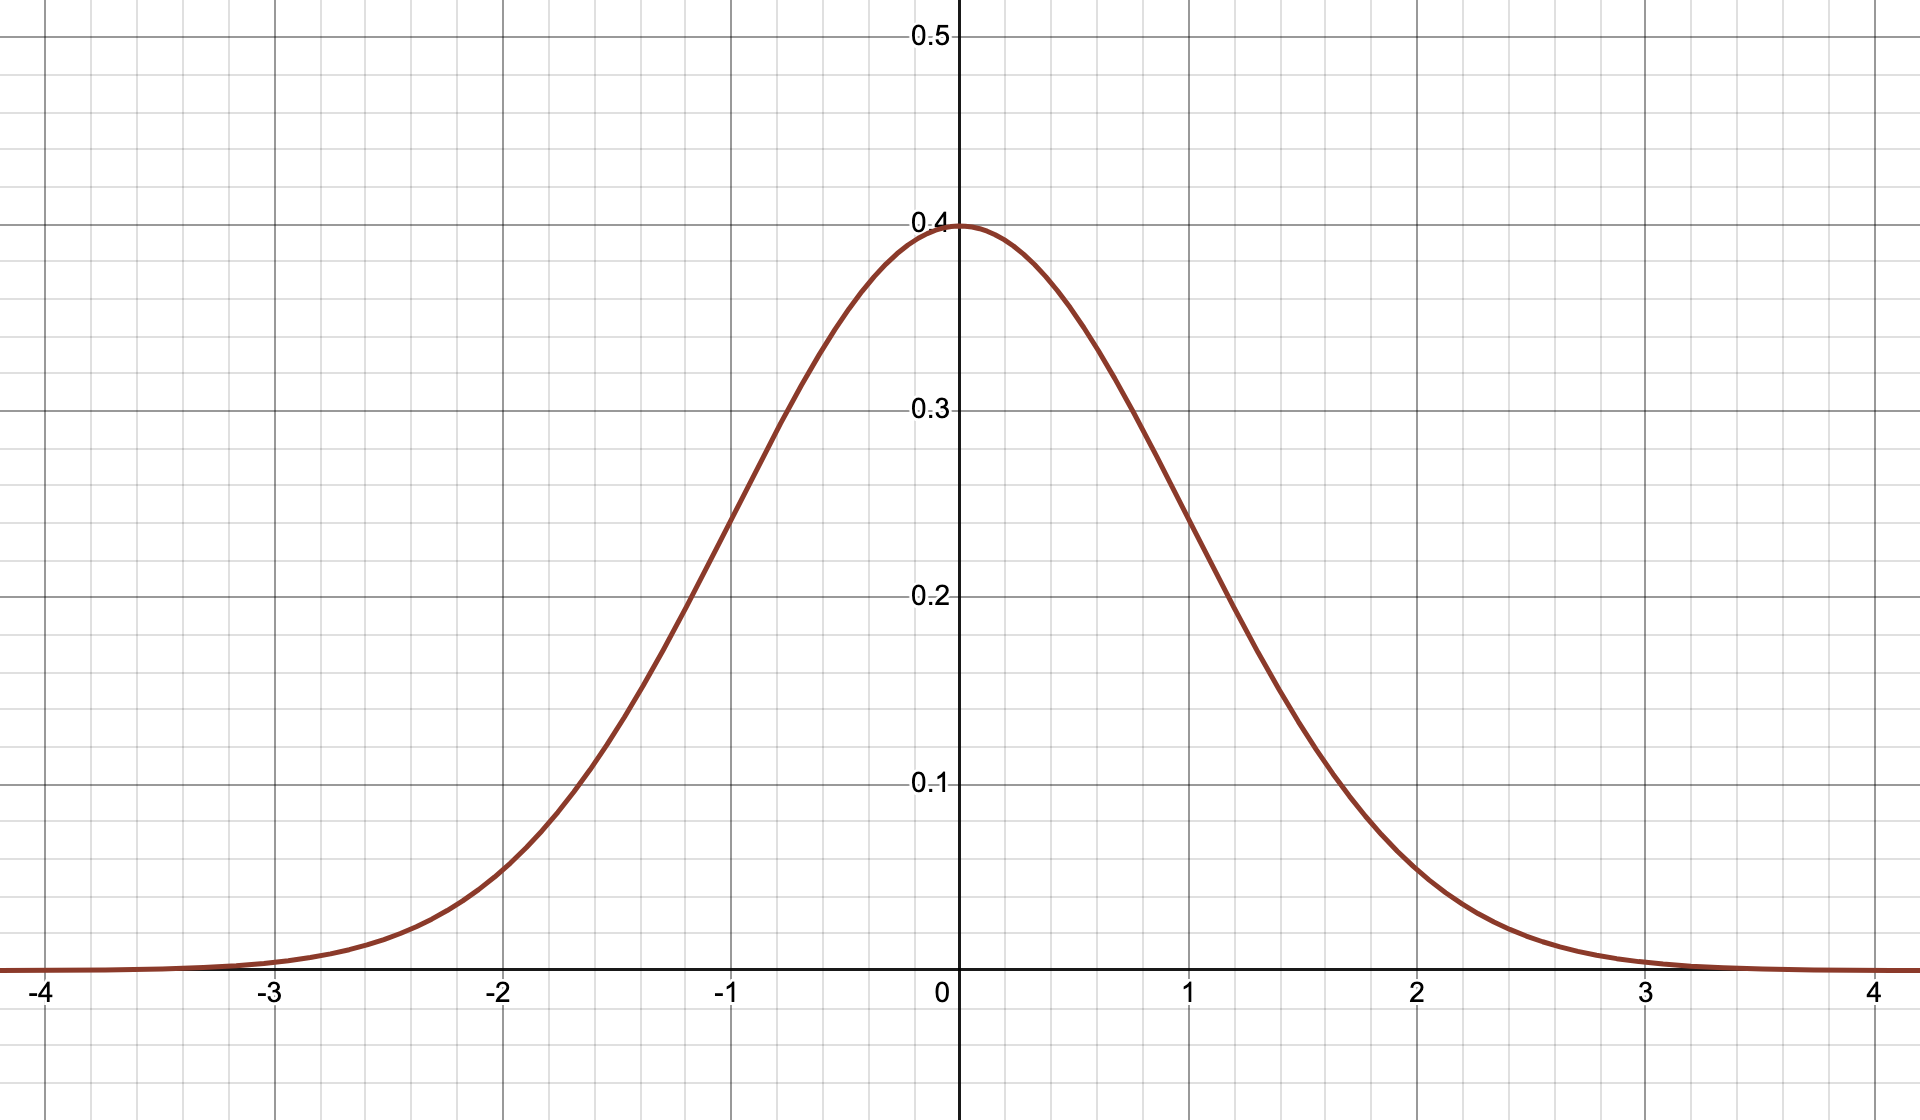
| 正态分布 N(μ,σ2) | 2πσ1e−(x−μ)2/(2σ2) | μ | σ2 |
概率对应密度曲线下的面积,不是曲线高度。图像由 Desmos 生成。
指数分布是 α=1 的伽马分布,并具有无记忆性。正态标准化为 (X−μ)/σ∼N(0,1)。
随机变量函数的分布
离散型随机变量逐个合并映射到同一新值的概率。连续型随机变量可先求分布函数;若 Y=g(X) 严格单调,反函数为 x=h(y),则
fY(y)=fX(h(y))∣h′(y)∣,
并注意 Y 的取值范围。
易错 非单调变换要按各个反函数分支求和,不能只取一个根。